Коротко. У DGX Spark 2 порта QSFP на 200 Гбит/с каждый, но вместе они дают не 400 Гбит/с сети. ConnectX-7 подключена к SoC двумя линками PCIe Gen5 x4, поэтому на весь узел приходится около 200 Гбит/с в каждую сторону, а один кабель отдаёт их только тогда, когда нагружены оба линка. Из этого факта следует любая схема: 1 кабель для 2 спарков, 3 кабеля треугольником для 3, кольцо или коммутатор для 4 и коммутатор дальше. По кабелям: 12 из 13 протестированных на моей паре дали одинаковые 185,1 Гбит/с. 13-й 101 минуту работал чисто при простаивающих GPU, а через 3 минуты после запуска нагрузки на GPU потерял линк.
У меня 2 ASUS Ascent GX10, у которых тот же суперчип GB10 и та же ConnectX-7, что и у DGX Spark. Они соединены одним кабелем. Всё, что ниже помечено как моё, измерено на этой паре. Я не собирал ни кольцо из 3 узлов, ни кольцо из 4, ни кластер с коммутатором, поэтому эти разделы опираются на документацию NVIDIA и отчёты других людей, и у каждого числа там указано, чьё оно.
Одно замечание до разговора о железе: про устройство посередине кластера из 4 узлов часто говорят «роутер». Вам нужен коммутатор. По инструкциям NVIDIA все порты, смотрящие на Spark, лежат в одной сети уровня L2, и ничего не маршрутизируется.
ConnectX-7: 2 порта, 2 рельса
Сетевую карту описывают 3 числа, и их легко перепутать.
| Предел | Значение | Что его задаёт |
|---|---|---|
| Один порт QSFP | до 200 Гбит/с | Сам порт |
| Один рельс (путь PCIe до SoC) | около 100 Гбит/с | Один линк PCIe Gen5 x4 |
| Весь узел, оба порта вместе | около 200 Гбит/с в каждую сторону | 2 рельса, общие для обоих портов |
SoC не может отдать одному устройству больше x4, поэтому NVIDIA подключила карту двумя отдельными линками x4. Каждый порт QSFP доступен по обоим, поэтому один порт дважды виден в Linux:
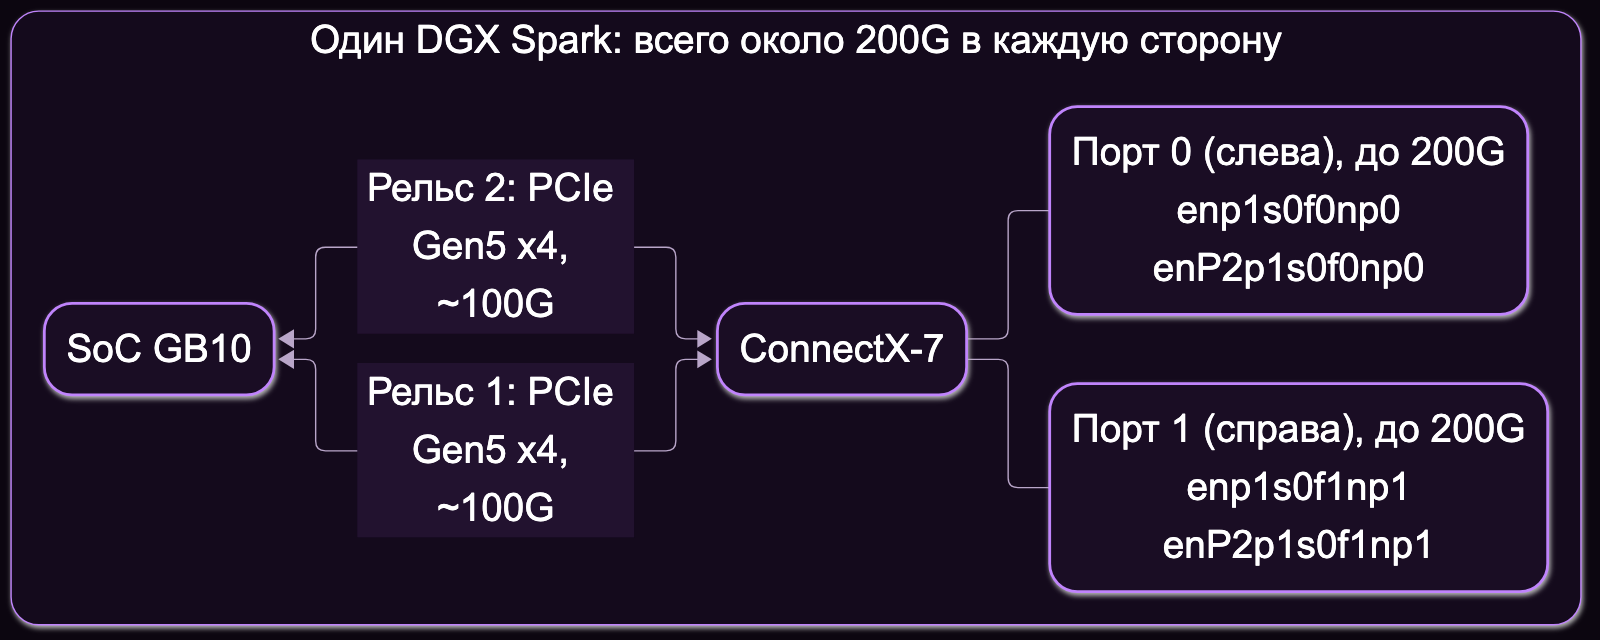
Устройства RoCE устроены так же: например, rocep1s0f1 и roceP2p1s0f1 для порта 1.
Если смотреть сзади, порт 0 ближе всего к обычному порту Ethernet. Имена одинаковы на каждом узле, как сказано в руководстве NVIDIA. Мои GX10 используют те же имена.
Вот как это выглядит на моей паре: один кабель, порт 1 в порт 1:
| Тест (мой) | Результат |
|---|---|
ib_write_bw, один рельс | 108,9 Гбит/с |
ib_write_bw, оба рельса сразу | 92,56 + 92,56 = 185,1 Гбит/с |
| NCCL all-reduce, один рельс | 13,6–13,9 ГБ/с |
| NCCL all-reduce, оба рельса | 18,3–19,0 ГБ/с |
Односторонняя задержка RDMA (ib_write_lat, типичная) | 1,42–1,96 мкс |
Процедура NVIDIA для двух Spark для того же теста публикует 189,85 Гбит/с.
Один открытый вопрос с моей стороны: 185,1 Гбит/с это 23,1 ГБ/с, а моя цифра NCCL заметно ниже. У других получается ближе. NADDOD сообщает о 23,76 ГБ/с на 2 узлах при сообщениях по 16 ГиБ и NCCL 2.30.7, тогда как у меня сообщения были от 256 МБ до 1 ГБ на NCCL 2.28.9. С их настройками я не перезапускал, поэтому считайте 19 ГБ/с тем, что я измерил, а не потолком.
Из этого следуют 3 вывода, которые экономят деньги:
- Второй кабель между теми же 2 спарками ничего не добавляет. Playbook говорит об этом прямо: «Использование двух кабелей не повысит производительность».
- Более быстрый кабель ничего не добавляет. Порт ограничен 200 Гбит/с, что бы ни было написано на кабеле.
- Оба рельса нужно задействовать специально. NCCL должен получить оба устройства RoCE порта, иначе вы получите половину полосы без всякой ошибки.
Есть ещё одна ловушка для тех, кто планирует mesh из 4 узлов. Рельсы разделяются на стороне PCIe, а не на порту, поэтому брейкаут 200G на 2×100G со стороны Spark не даёт 2 линков. Resilient Tec, продавец кабелей, собирает сообщения с форумов о том, что одно плечо поднимается, а другое остаётся мёртвым. У Spark ровно 2 соседа.
Как выбирать кабель
NVIDIA одобряет 2 кабеля, оба пассивные DAC QSFP112: Amphenol NJAAKK-N911 (400 мм, 32 AWG; NJAAKK0006 это версия 0,5 м) и Luxshare LMTQF022-SD-R (400 мм, 30 AWG). Собственное правило руководства проще: не менее 200 Гбит/с, Ethernet.
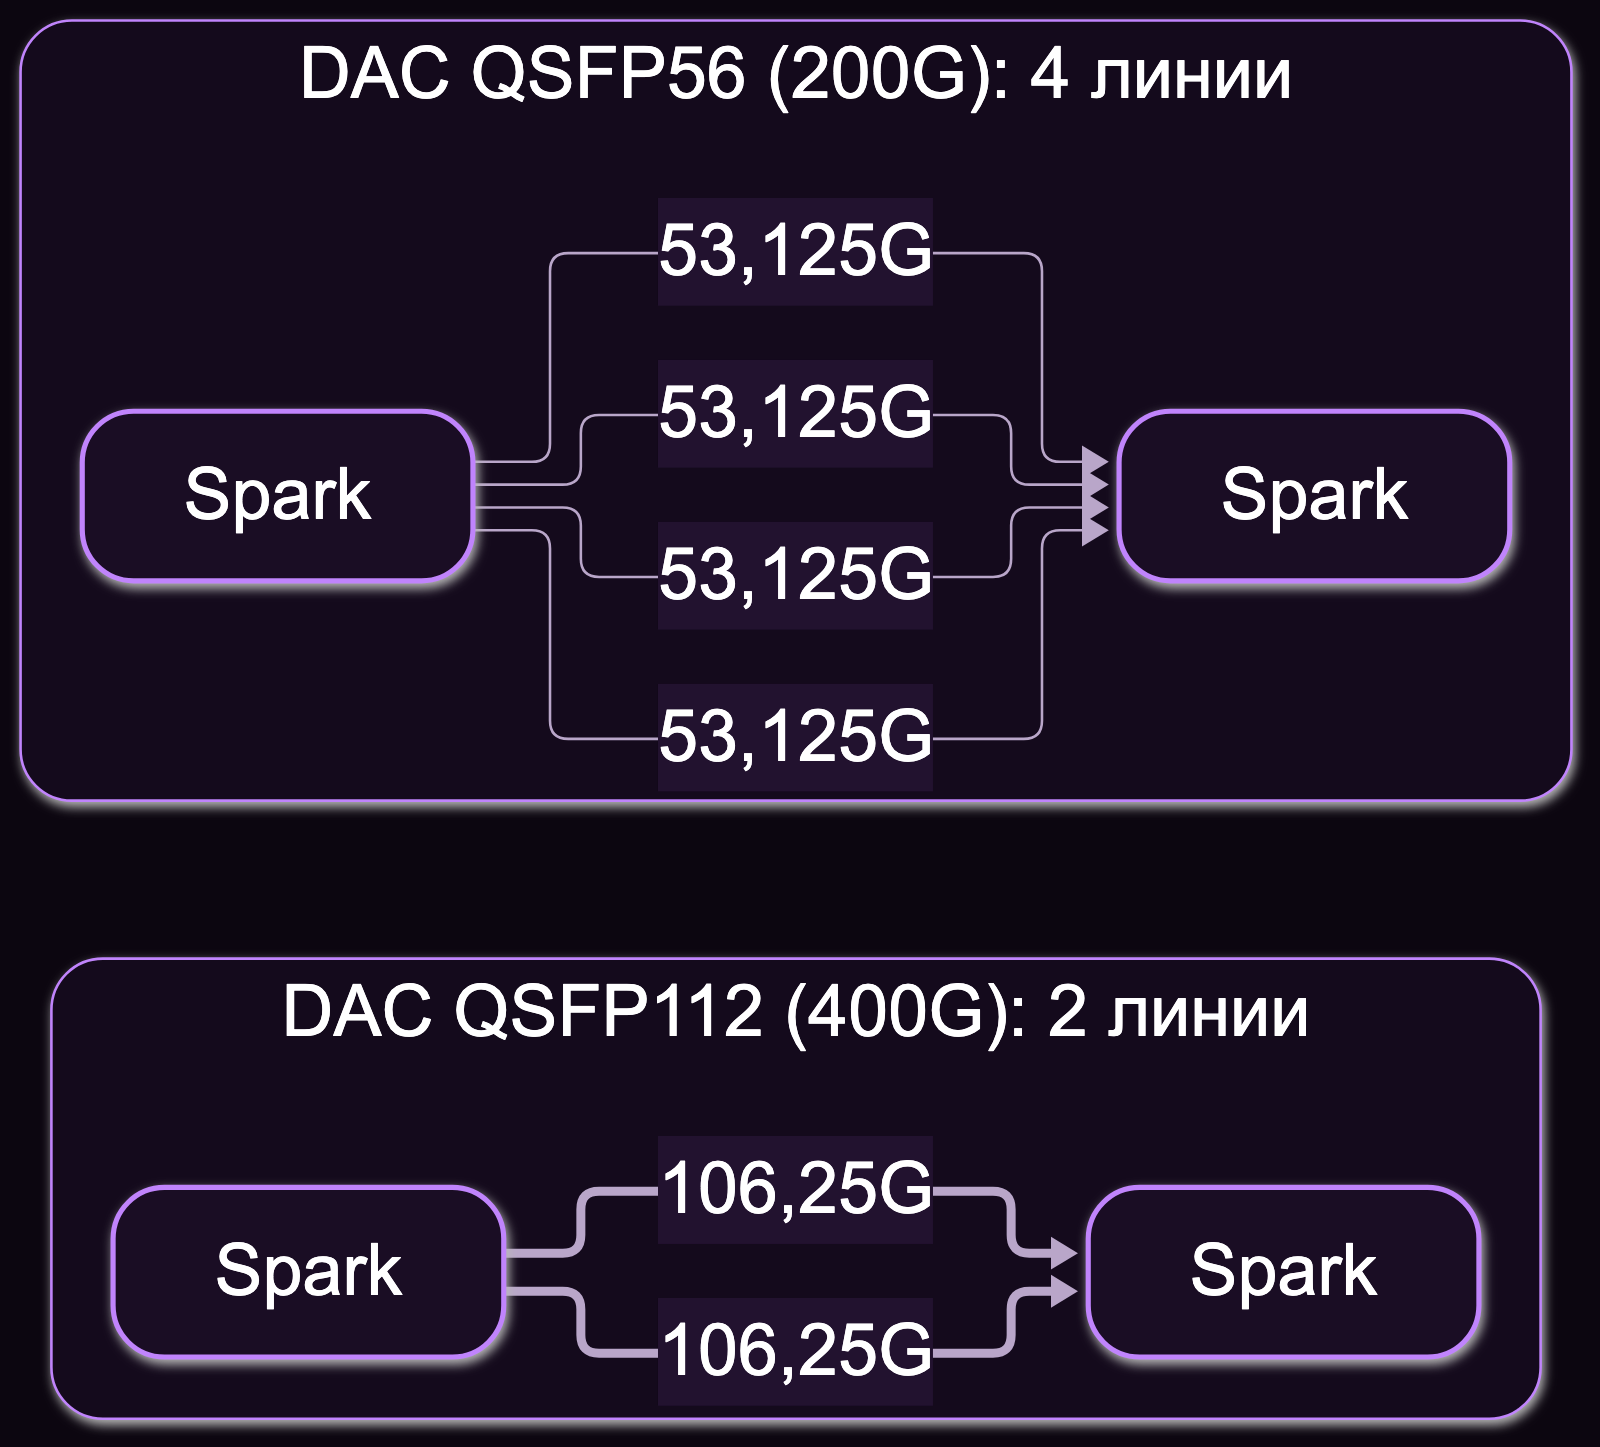
На практике работают 2 семейства кабелей, и линк они поднимают по-разному. Этого я нигде больше в явном виде не видел:
| Кабель | Линк, который согласует Spark | Используемые линии | Rate в /sys/class/infiniband/<dev>/ports/1/rate |
|---|---|---|---|
| DAC QSFP112 («400G») | 200 Гбит/с | 2 × 106,25G | 2X NDR |
| DAC QSFP56 (200G) | 200 Гбит/с | 4 × 53,125G | 4X HDR |
То есть кабель 400G на этом порту не работает вполсилы на 4 линиях. Он использует 2 линии с более высокой скоростью. Кабель QSFP56 использует все 4 с вдвое меньшей скоростью.
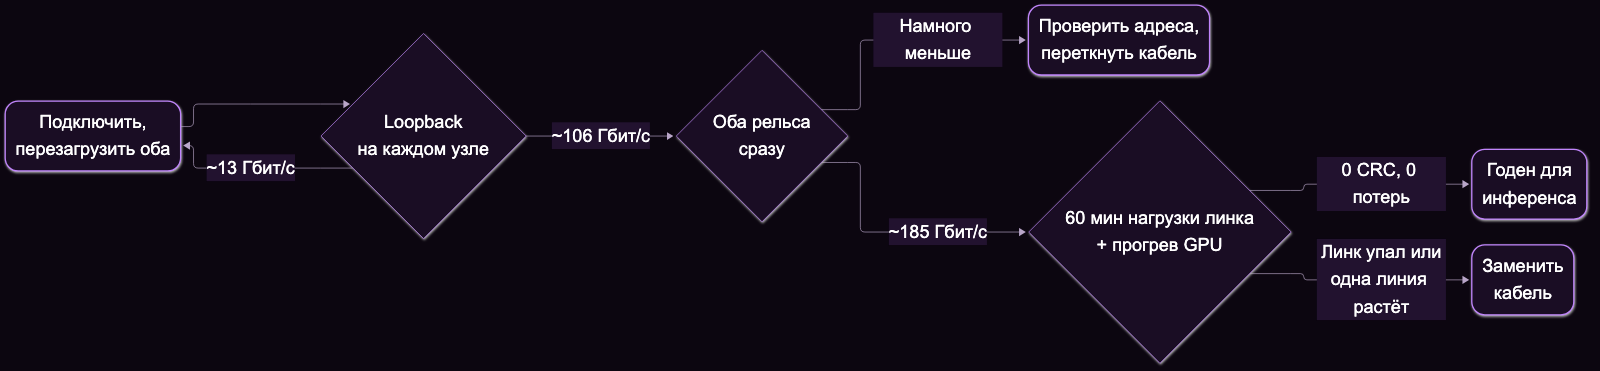
Сейчас я протестировал на этой паре 13 кабелей, каждый по одной процедуре: бенчмарки NVIDIA, затем 10 минут линка под полной нагрузкой при простаивающих GPU, затем 60 минут линка под полной нагрузкой при загруженных GPU на обоих узлах. Исходный кабель появился раньше теста под нагревом, но несколько недель обслуживал инференс без сбоев.
| Семейство кабелей | Протестировано | Скорость | BER до FEC на худшей линии | Итог |
|---|---|---|---|---|
| QSFP112, 2 линии | 9 | 185,1 Гбит/с, у всех | от 10⁻⁸ до 4×10⁻⁷ | 9 в порядке (0 ошибок CRC) |
| QSFP56, 4 линии | 3 | 185,1 Гбит/с, у всех | 0 (ни в одной выборке нет FEC-коррекций) | 3 в порядке |
| Клон QSFP56, 4 линии | 1 | ~195 Гбит/с в каждую сторону при простаивающих GPU | ~5×10⁻⁸ до отказа | Потерял линк под нагревом |
Читать эту таблицу надо осторожно, в обе стороны.
Скорость не отличает кабели друг от друга. Все кабели, дошедшие до конца бенчмарка, показали одно и то же число, поэтому тест скорости говорит лишь о том, что кабель не сломан.
4 линии выглядели гораздо чище, чем 2. 3 хороших кабеля QSFP56 за 70 минут не дали ни одной исправленной ошибки, включая нагрев до 82 °C, а все кабели QSFP112 стабильно давали небольшой поток исправленных ошибок. Он безвреден: предел RS-FEC около 2×10⁻⁴, это больше чем на 2 порядка выше худшего кабеля, и ни один не дал ошибок CRC. Похоже на эффект запаса из-за более высокой символьной скорости, но 3 кабеля из 2 партий, все по 0,5 м, это не доказательство.
Отказавший кабель был QSFP56. Не выводите из строки выше, что «QSFP56 безопаснее». Этот клон с маркировкой ONT-DAC-QS56-0.5 держал линк под полной нагрузкой 101 минуту при простаивающих GPU, с 0 потерями линка и 0 ошибок CRC. Когда GPU загрузили, карта нагрелась до 81 °C, число ошибок на одной линии выросло примерно с 2,9 тыс. до 11,7 млн в секунду, и на 3,1-й минуте линк упал на обоих узлах. В работе он сбрасывался 4 раза за 20 часов, и каждый сброс убивал распределённый движок инференса. Частота ошибок за 30 секунд до обвала выглядела безобидно; единственным предупреждением была одна линия с примерно в 1000 раз большим числом ошибок, чем у остальных.
Мои правила покупки кабеля:
- По умолчанию берите одобренный QSFP112 или QSFP56 от известного источника. Только по одобренным кабелям с NVIDIA можно будет разговаривать в поддержке. QSFP56 200G MCP1650-V00AE30 это дешёвая альтернатива, которую подтверждают отчёты пользователей ($79 против $174 за NJAAKK-N911 у Resilient Tec в ноябре 2026 года, по странице продавца), но в списке NVIDIA его нет.
- Покупайте самый короткий, который достаёт. 0,5 м подходит для узлов, поставленных друг на друга. Продавцы указывают пассивные QSFP56 200G до 3 м. Длиннее 0,5 м я ничего не тестировал и не нашёл первоисточников по AOC и оптике в клетках Spark, так что дальше 3 м проверяйте всё сами.
- Читайте EEPROM и не доверяйте ему.
sudo ethtool -m enp1s0f1np1показывает, что вы купили. Отказавший кабель сообщал затухание 0 дБ на 7 и 12,9 ГГц, это заглушка, а не измерение. Длина меди в EEPROM по SFF-8636 указывается в целых метрах, поэтому кабель 0,5 м может читаться как 1 м. - Прогревайте всё, что будет нести инференс. Дайте линку полную нагрузку при загруженных GPU на обоих узлах и следите за частотой
rx_err_lane_N_phyпо каждой линии на обоих приёмниках. Тест при простаивающих GPU пропустил бы тот единственный кабель, который отказал.
Что проверить после подключения
Есть ловушка, из-за которой любой кабель выглядит плохим. На моих узлах после замены кабеля или обновления ядра скорость карты может упасть примерно до 13 Гбит/с, хотя линк по-прежнему сообщает 200 Гбит/с и ethtool выглядит нормально. Loopback ib_write_bw с обоими концами на одном узле занимает 10 секунд и не использует провод: около 106 Гбит/с означает, что карта в порядке, около 13 Гбит/с означает, что сработало ограничение. Перезагрузка обоих узлов у меня обычно это убирала, хотя 2026-11-05 понадобилось 2 попытки. itadmin.blog пишет, что потребовался полный сброс питания: 60 с без шнура. Сначала попробуйте перезагрузку и пусть решает loopback. Строка 27W insufficient power в dmesg появляется и в нормальном режиме, и при ограничении, её игнорируйте.
Какой кабель для какой схемы
| Схема | Что купить | Количество |
|---|---|---|
| 2 спарка | DAC QSFP112 или QSFP56, 0,5 м | 1 |
| 3 спарка, треугольник | То же | 3 |
| 4 спарка, кольцо | То же; длины, возможно, придётся планировать | 4 |
| 4–8 спарков, коммутатор с портами 400G | Брейкаут 400G QSFP-DD на 2× 200G QSFP56 (класс MCP7H60-W00x), только со стороны коммутатора | 1 на 2 спарка |
| 4–8 спарков, свободный порт коммутатора на каждый спарк | Прямой DAC 200G QSFP56, 1–3 м | 1 на спарк |
Обратите внимание на семейство кабелей в строках про коммутатор. У коммутаторов MikroTik 400G, о которых ниже, линии по 50G, поэтому Spark работает там на 4 линиях, и найденные мной отчёты используют QSFP56. Кабель QSFP112 на таком коммутаторе я не пробовал.
2 спарка: 1 кабель
Эту схему использую я. Берите порт 0 на обоих концах или порт 1 на обоих концах; вспомогательный скрипт NVIDIA ожидает, что они совпадают.
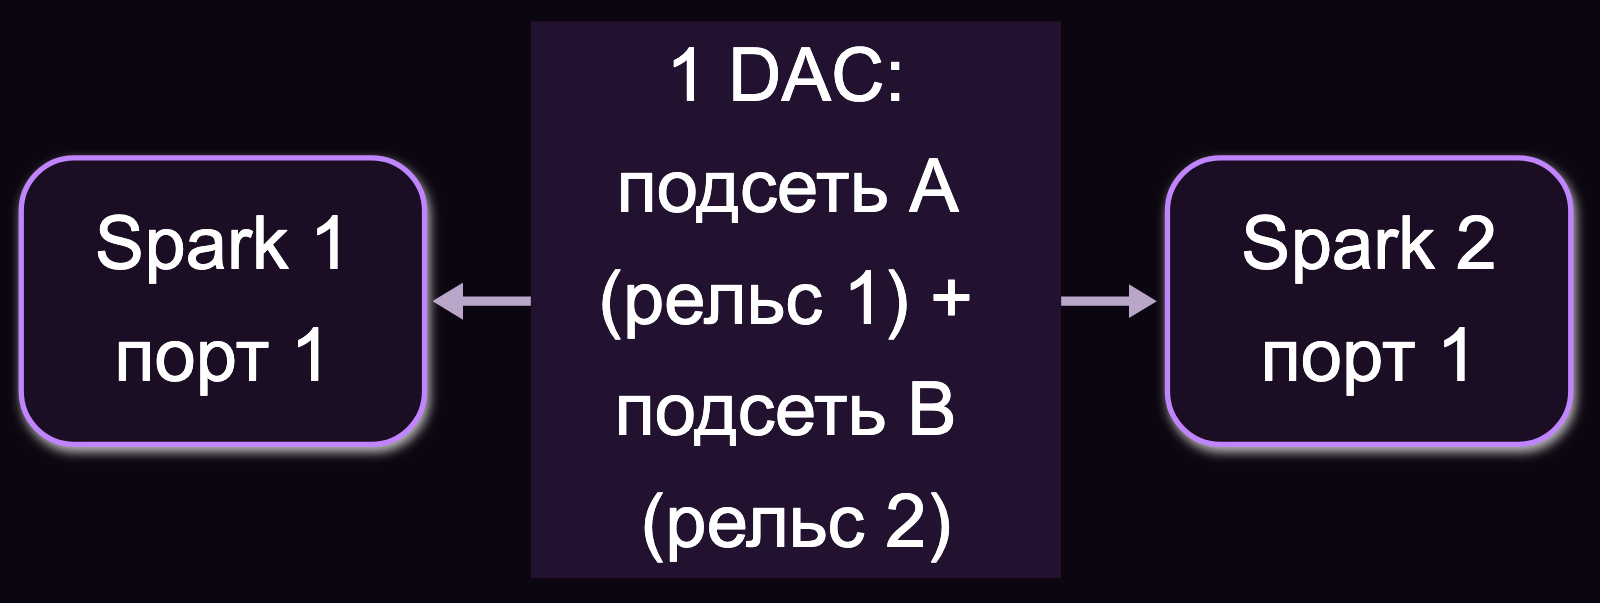
План адресов следует из рельсов: 2 подсети /24 поверх 1 кабеля, по одной на рельс. Playbook NVIDIA теперь делает это скриптом из spark-vllm-docker (запускайте с одного из Spark):
./setup-cluster.sh 192.168.1.11 192.168.1.12 --topology direct --mtu 9000 --dry-run
NVIDIA задаёт MTU 9000 только для этой схемы; на моём линке по сравнению с 1500 прироста не было. Для NCCL укажите оба устройства порта, в который воткнут кабель:
export NCCL_IB_HCA=rocep1s0f1,roceP2p1s0f1
Затем проверьте, что в выводе NCCL_DEBUG=INFO есть оба имени. Одно имя и около 13,9 ГБ/с означают, что вы работаете по одному рельсу.
3 спарка: треугольник из 3 кабелей
Коммутатор не нужен. Каждый Spark использует оба порта, а 3 узла в кольце это ещё и полный mesh, так что каждый узел в 1 хопе от любого другого. Схема подключения строгая: порт 0 всегда идёт в порт 1 следующего узла.
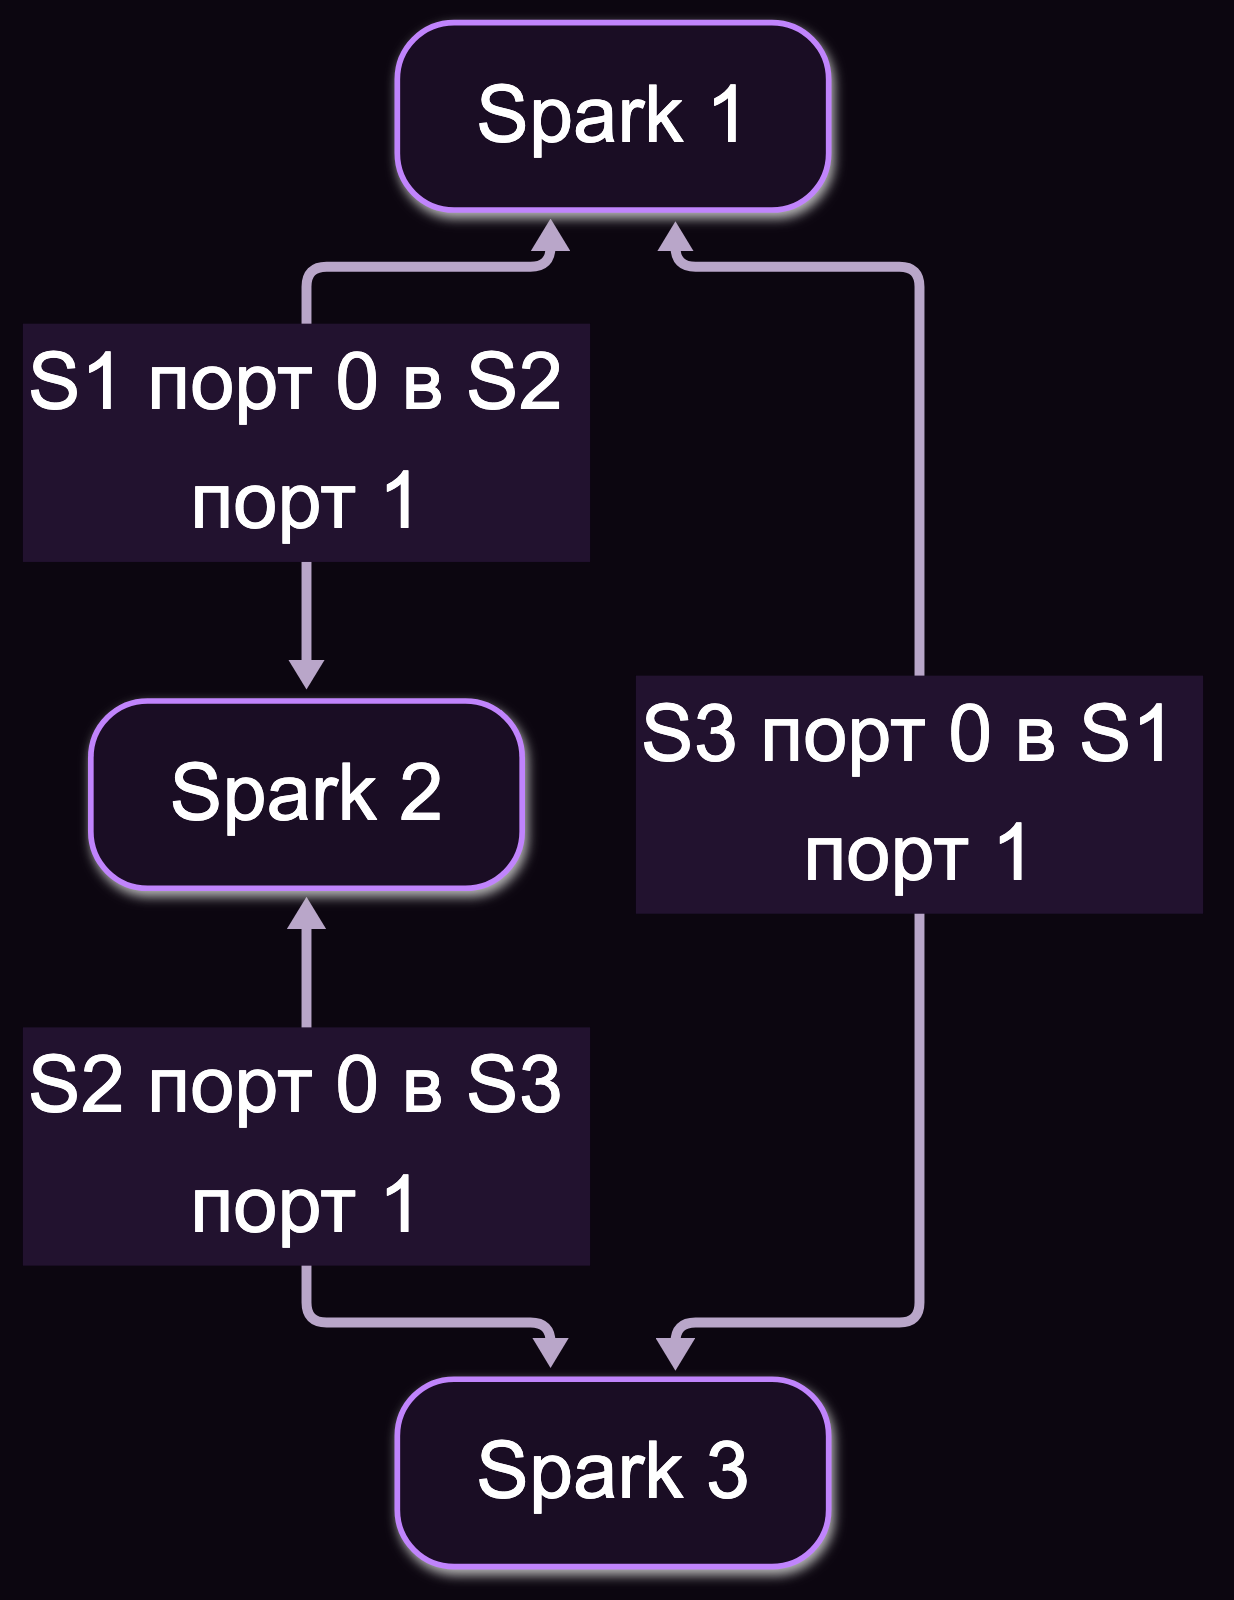
Получается 2 подсети на кабель, 6 всего. Скрипт называет эту схему mesh, и NVIDIA велит использовать здесь MTU 1500. Cluster Assistant в NVIDIA Sync тоже её поддерживает: до 3 спарков напрямую, 4 через коммутатор.
./setup-cluster.sh 192.168.1.11 192.168.1.12 192.168.1.13 --topology mesh --mtu 1500 --dry-run
С полосой строка «200 Гбит/с на порт» вводит в заблуждение. Каждый кабель может нести 200 Гбит/с, когда занят он один, но у узла по-прежнему 2 рельса. Когда трафик идёт к обоим соседям одновременно, закладывайте около 100 Гбит/с на каждого. Заметки spark-vllm-docker дают ту же цифру 100G для каждой пары.
Для инференса это должно значить меньше, чем кажется, хотя на 3 узлах я этого не измерял. На моей паре обслуживание модели на 284B с тензорным параллелизмом использовало 0,64% линка. Массовые передачи вроде копирования весов разделение почувствуют.
4 спарка: кольцо или коммутатор
Здесь выбор настоящий. Полный mesh невозможен: ему нужно 3 линка на узел, а у Spark их 2.
Кольцо требует 4 кабеля: порт 0 в порт 1 следующего узла, а последний замыкается обратно на Spark 1. Spark 1 и 3 напрямую не соединены, как и 2 и 4. Playbook описывает его с 8 подсетями и --topology ring, но только для ручной настройки: NVIDIA Sync её не конфигурирует. Старые материалы называют кольцо неподдерживаемым и требующим собственной сборки NCCL, так что смотрите на дату всего, что читаете. Для стоечной установки у Resilient Tec стоит украсть один совет: соединяйте 1→2→4→3→1, чтобы ни один кабель не тянулся через всю стопку, а узлы передавайте скрипту в порядке прокладки кабелей, а не в порядке стойки.
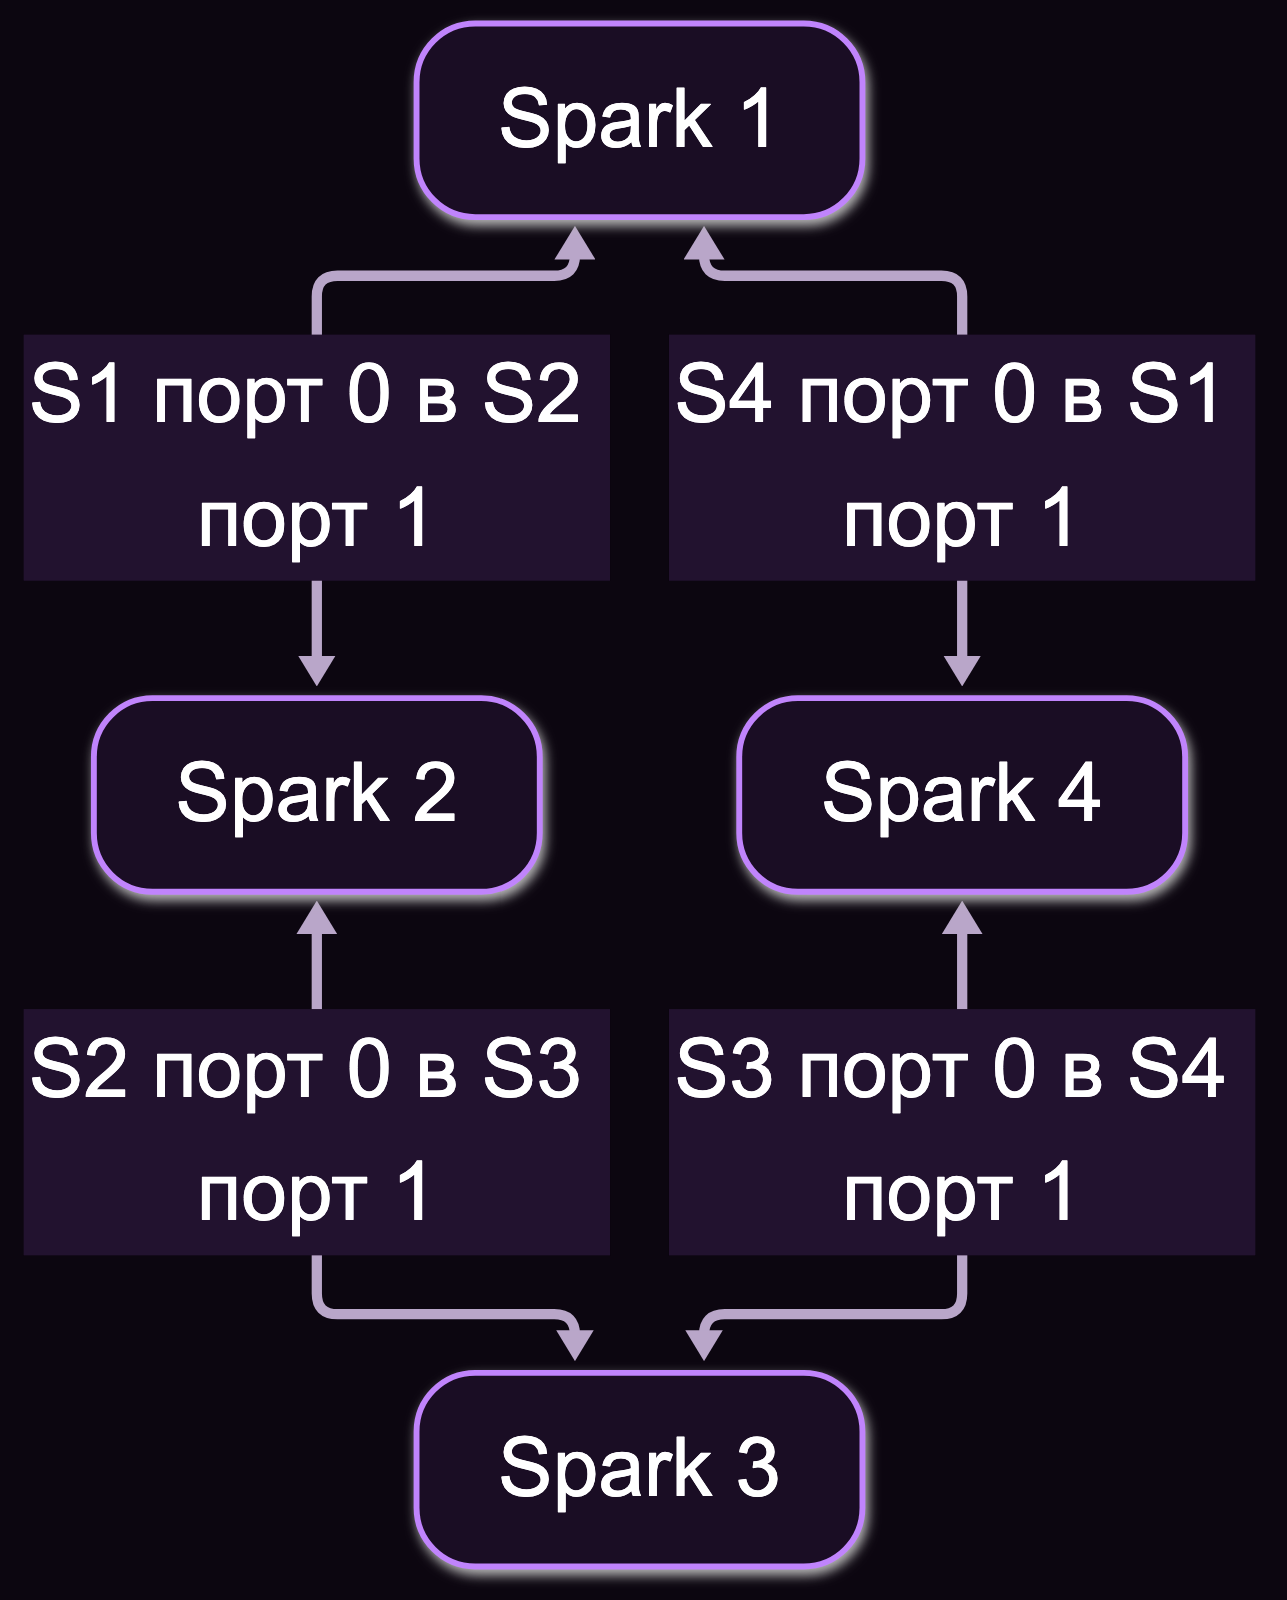
Коммутатор требует по одному кабелю на каждый Spark, в порт с одним и тем же номером на каждом узле. Он даёт связность любого с любым и единственный путь дальше 4, который рекомендует NVIDIA.
Сколько даёт коммутатор на 4 узлах? 3 источника, ни один не мой:
| Источник | Кольцо | Коммутатор | Прирост |
|---|---|---|---|
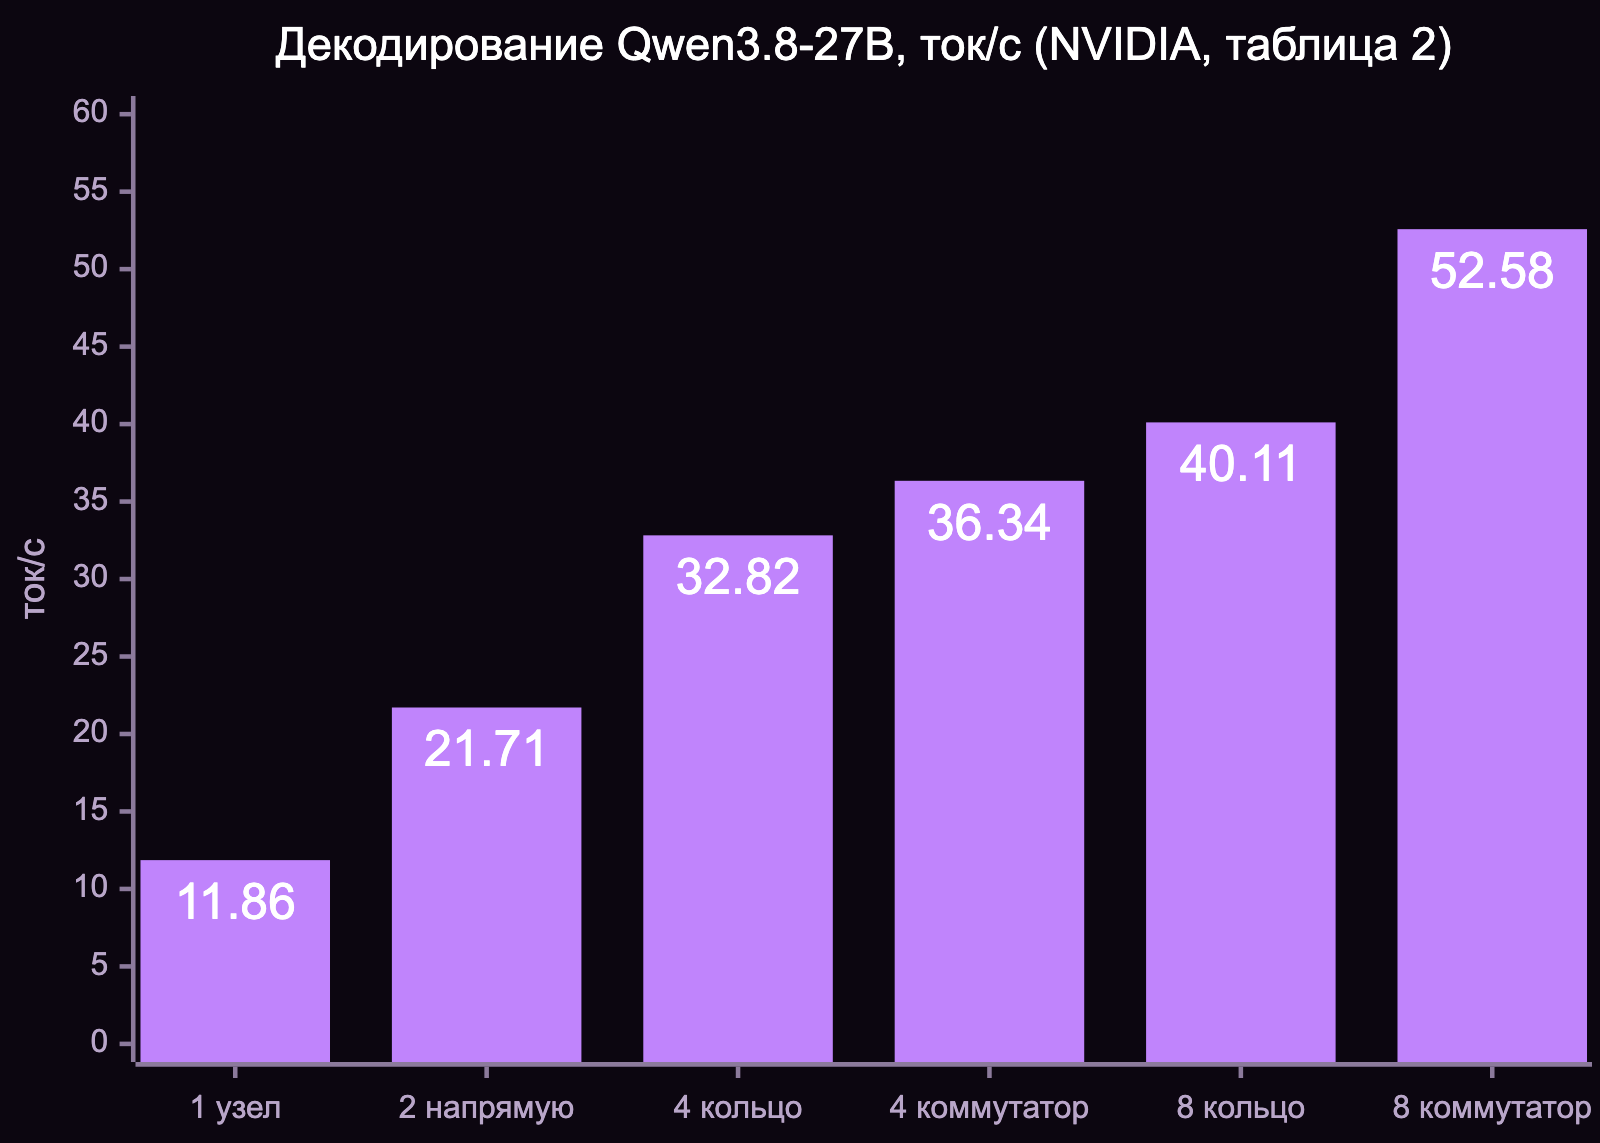
| NVIDIA, декодирование Qwen3.8-27B | 32,82 ток/с | 36,34 ток/с (с RoCEnante) | +10,7% |
| r/DGX_Spark, NCCL all-reduce, CRS812 | 23,8 ГБ/с | 24,1 ГБ/с | +1,3% |
| Та же ветка, DeepSeek-V4.1-Flash у одного из комментаторов, CRS804 | 85,66 ток/с | 92,23 ток/с | +7,7% |
Числа с Reddit принадлежат продавцу кабелей и комментатору, и запуски отличаются, поэтому смотрите на диапазон, а не на какую-то одну строку. Кластер из 4 узлов коммутатор радикально не меняет. Берите кольцо, если 4 это ваш окончательный размер и одна модель занимает все узлы. Берите коммутатор, если хотите делить кластер, гонять all-to-all в стиле MPI или использовать RoCEnante, бэкенд NVIDIA, который работает только на кластерах с коммутатором. Те же рассуждения NVIDIA приводит в своём посте: в кольце нельзя выделить независимые группы.
От 5 до 8 спарков: коммутатор
NVIDIA объявила официальную поддержку 8 узлов на GTC Berlin 2026-10-22, а поддержка в Sync обещана до конца года. До тех пор Sync и скрипт останавливаются на 4 узлах через коммутатор, а дальше настраивать нужно вручную. На 8 узлах NVIDIA намерила 40,11 ток/с на кольце и 52,58 на коммутаторе с RoCEnante, так что здесь коммутатор даёт уже 31%.
Коммутаторы, которыми владельцы действительно пользуются, с ценами со страниц продавцов в октябре и ноябре 2026 года:
| Коммутатор | Порты | Spark на 200G | Цена по прайсу | Примечания |
|---|---|---|---|---|
| MikroTik CRS504-4XQ-IN | 4 × 100G QSFP28 | 0 (4 на 100G) | $799 | Половинная скорость, по отзывам проще найти; вне рекомендаций NVIDIA по 200G |
| MikroTik CRS804-4DDQ | 4 × 400G QSFP56-DD | 8 с брейкаутами | $1 295 | Около 92 Вт в типичном режиме |
| MikroTik CRS812-8DS-2DQ-2DDQ | 2 × 400G, 2 × 200G, 8 × 50G | 6 с брейкаутами | не проверял | 4 плеча брейкаута + 2 прямых |
| NADDOD N9200-32DC | 32 × 400G | 64 с брейкаутами | $10 459 | SONiC, PFC и ECN; есть место под хранилище и аплинки |
Наличие это реальное ограничение. В сентябрьской ветке на форуме оба MikroTik были под заказ до января 2027 года, хотя другой автор видел остатки в Европе.
Брейкауты нужны только со стороны коммутатора: 1 порт 400G превращается в 2 плеча по 200G, и каждый Spark получает целый неразделённый порт.
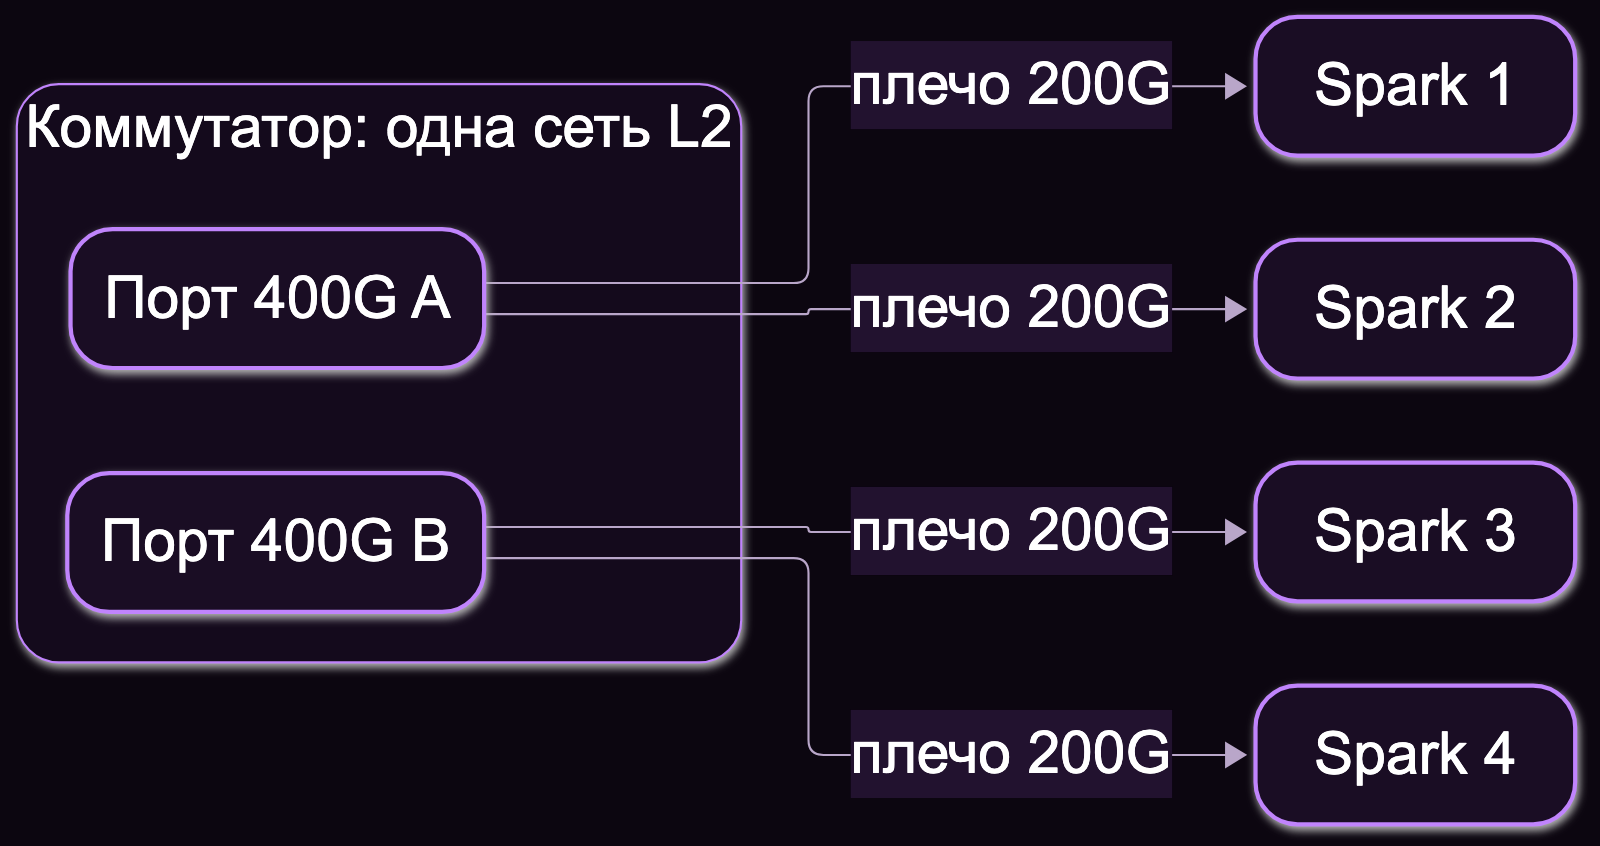
Чек-лист NVIDIA для коммутатора короткий: каждый порт, смотрящий на Spark, выставлен на 200 Гбит/с, все в одной сети L2, аппаратное ускорение (hardware offload) подтверждено, MTU по умолчанию и никакого смешения прямых и коммутируемых линков. Адресация отличается от прямого подключения: 2 общие подсети на весь кластер, и у каждого Spark по одному адресу в каждой.
Коммутатор это ещё и то место, где здоровый на вид линк начинает вести себя плохо. itadmin.blog описывает 4 Spark на CRS804, застрявших примерно на 10 Гбит/с при чистых линках 200G, и 3 отдельные причины:
- Мост не был аппаратно ускорен. Неиспользуемые подпорты брейкаута сидели в мосте управления, поэтому трафик шёл через процессор коммутатора. Выдаёт это высокая загрузка процессора коммутатора во время передачи.
- PFC остановил RoCE. Соединения поднимались, а данные не шли. Эта сборка закончилась на RoCE без потерь с выключенным PFC.
- Одинаковые IP на разных рельсах вызвали ARP flux. У каждого рельса должен быть свой адрес.
После этих исправлений сборка вышла на 109 Гбит/с на рельс и 23,33 ГБ/с NCCL на 4 узлах. По поводу PFC отчёты расходятся: руководство OpenZeka включает его на одном приоритете. Не копируйте ни один рецепт вслепую. После каждого изменения проверяйте линейную скорость через NCCL all-reduce.
Итог
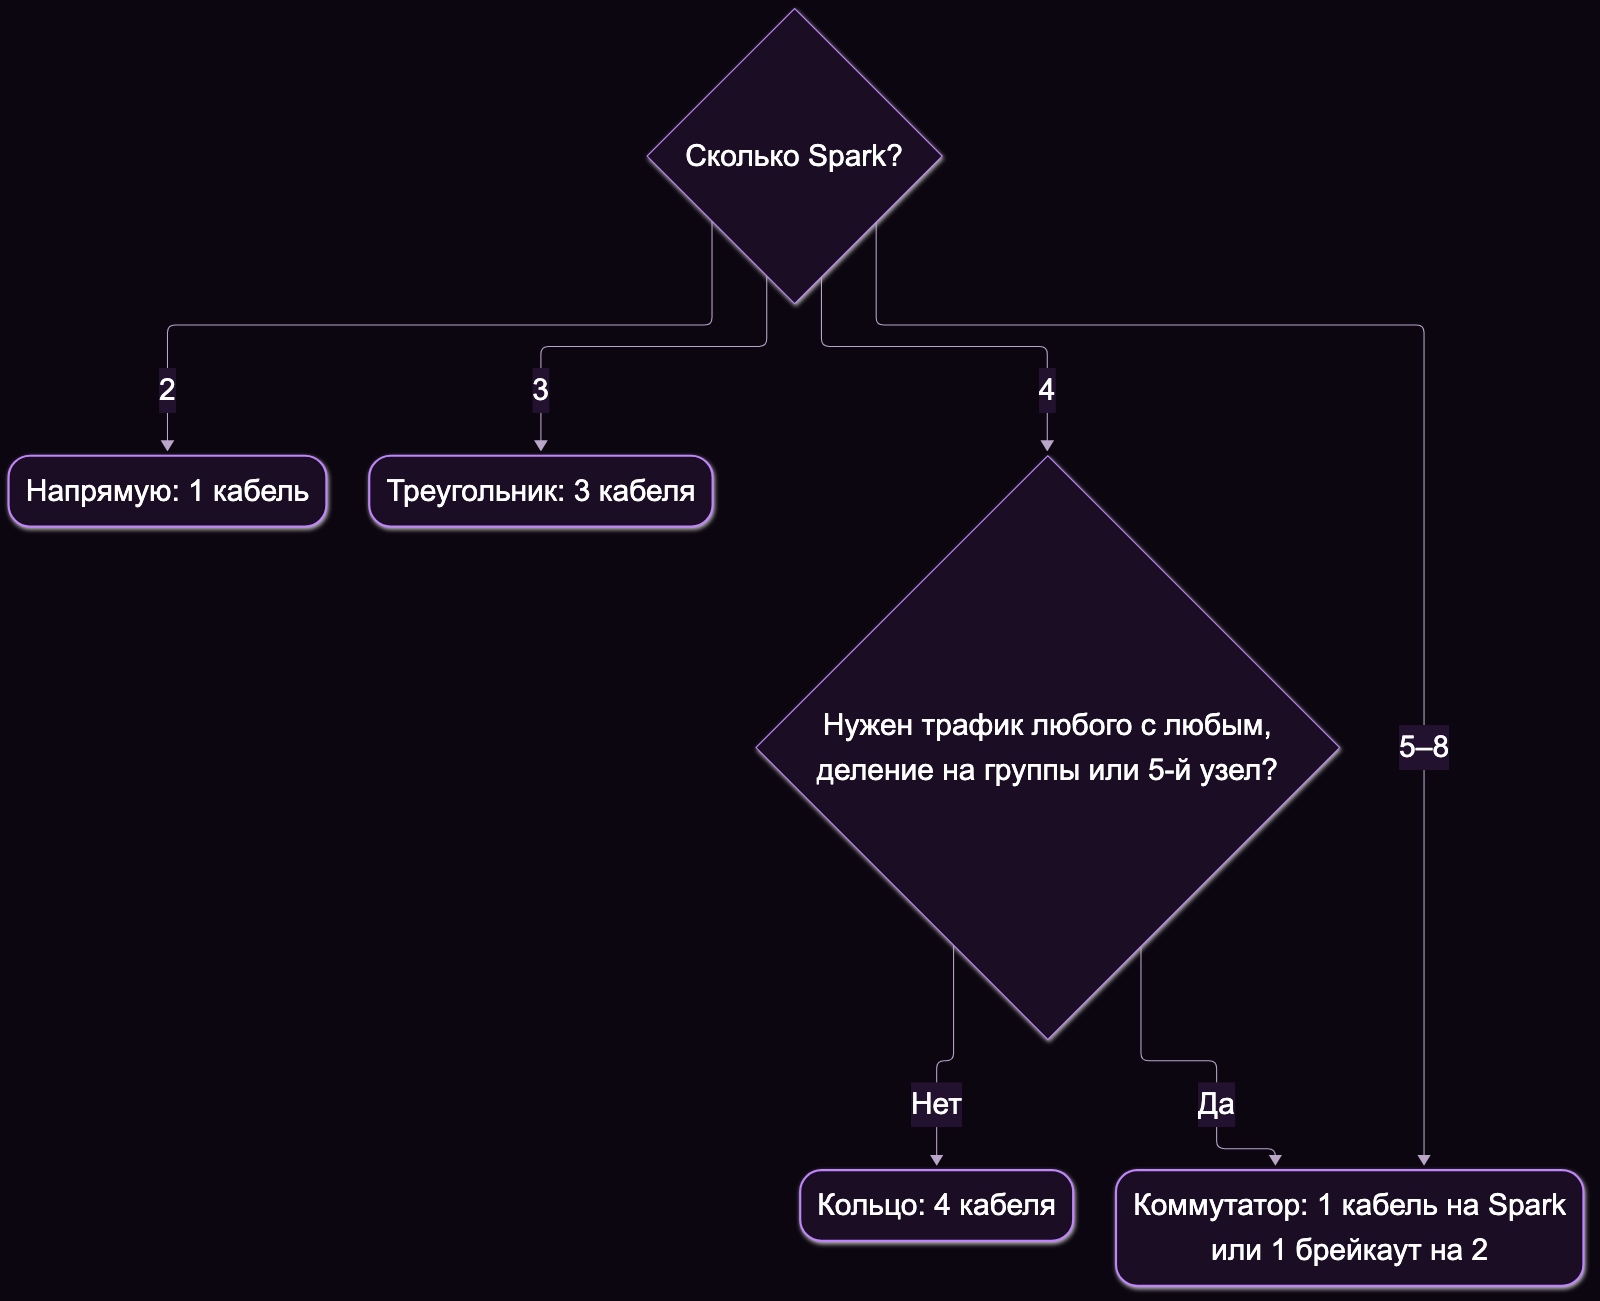
| Spark | Схема | Кабели | Ожидаемая полоса | Настройка |
|---|---|---|---|---|
| 2 | Напрямую | 1 | ~185 Гбит/с (мой замер) | Sync или скрипт |
| 3 | Треугольник | 3 | 200G на одном линке, ~100G на каждый при обоих занятых | Sync или скрипт |
| 4 | Кольцо | 4 | Тот же итог на узел | Только скрипт |
| 4 | Коммутатор | 4 или 2 брейкаута | ~24 ГБ/с NCCL (у других) | Sync или скрипт, коммутатор вручную |
| 5–8 | Коммутатор | 1 на спарк или 1 на 2 | Тот же итог на узел | Пока вручную |
Каким бы ни был размер, у узла 2 рельса, и никакой кабель или топология не добавят третий.